微积分在林业生长经营模型中的应用
生长是微分,资产是积分——林地滚动投资、经营方案编制与林业 AI 大模型,共用的一套数学
三件事看着不搭:一份讲林地滚动投资的白皮书、一份县级林业局的森林经营方案、一个大模型的对话框。
但它们其实是同一个东西的三个侧面。经营方案要回答「这片林子第 23 年能出多少材」,这是积分;生物性资产要回答「今年这块林子值多少钱」,这还是积分;滚动的林地投资要回答「今年该不该再收一块、什么时候主伐」,这是在约束下求极值。而大模型要做的,是把人的话翻译成参数,再把参数跑出来的结果翻译回人话。
一、FCIM 不是「买地砍树」,是把四个动作连成一只飞轮
FCIM(Forest Compounding Investment Model,林地复利经营模型)是中森生态与骏东控股 2026 年联合发布的一套模型,定位是「A TIMO-Based Model」——在 TIMO(林地投资管理组织)「收储—经营—采伐—再收储」的老循环上,叠加两条精深加工转化路线(天然来源生物医药、林木生物基材料)与长期机构资本。
白皮书对「复利」的定义很克制,值得原文照抄一句:复利不是对林木价格或土地价值的刚性收益承诺,而是可审计经营变量的持续改善——单位面积可售生物资源的质量与稳定供应、同一资源在加工与品牌原料环节的价值捕获、以及回款再收储的资产组合纪律。
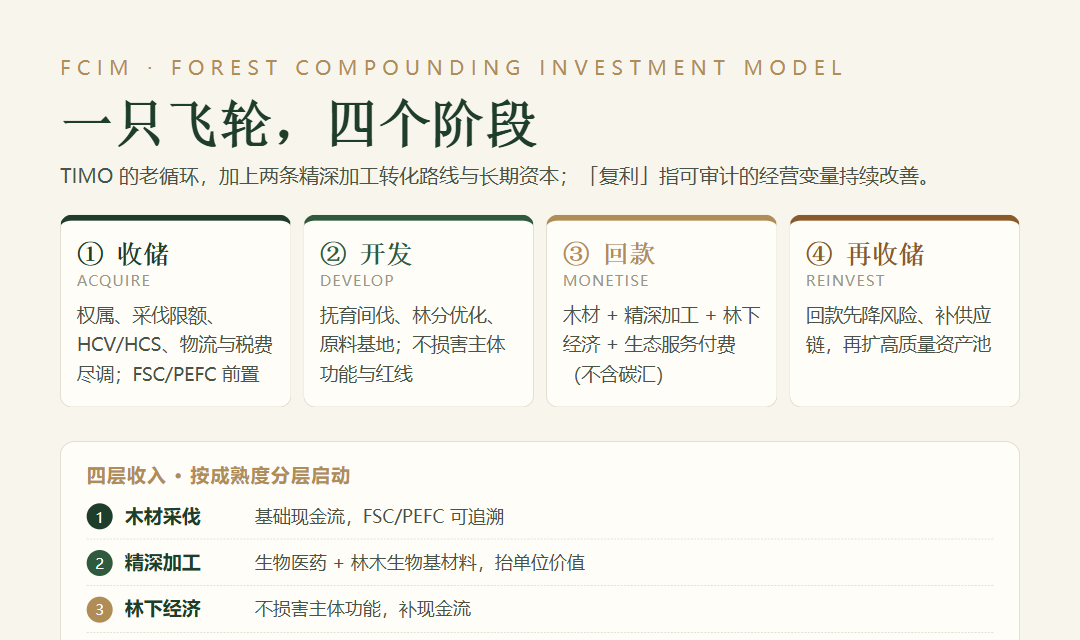
这里有一句我特别想划重点的话:只有当新增林地能提高组合质量、供应链稳定性或加工经济性时,面积扩张才构成有效复利——为规模而收购只会放大资本占用。
翻译成数学,这句话就是一个带约束的优化问题:扩张的边际收益必须覆盖边际资本成本与边际风险,否则解不在边界上,而在内部。很多「林业投资」的失败,不是不会算生长量,而是把这条约束丢了。
二、经营方案里的微积分:三处真刀真枪
森林经营方案不是散文,它是一份要被林业主管部门审、要被采伐限额约束、要被审计核查的技术文件。里面至少有三次,你必须动微积分。
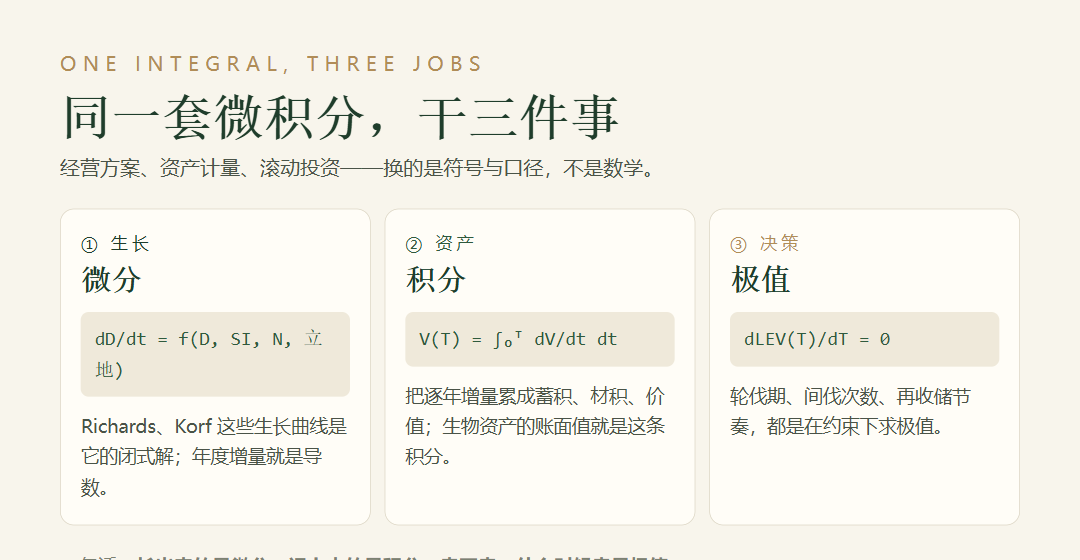
① 生长:把离散的实测连成连续的函数。固定样地五年复测一次,但方案要回答「第 17.3 年郁闭度多少、蓄积多少」。胸径生长可以写成 dD/dt = f(D, SI, N, 立地),而 Richards、Korf、Weibull 这些经验生长曲线,本质上就是它的闭式解。方案编制里的「生长表内插」,数学上就是对导数场做数值积分——以前手算 Simpson,现在跑 Runge–Kutta,活还是那活。
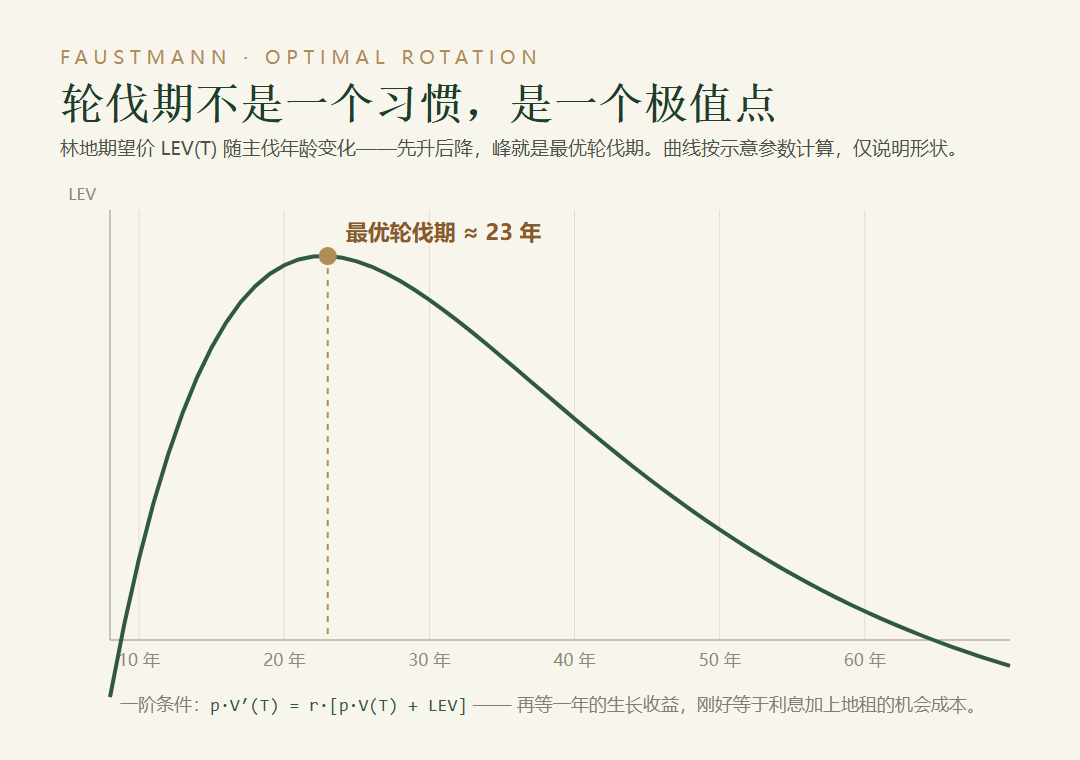
② 轮伐:Faustmann 公式,一个标准的极值问题。林地期望价 LEV 对主伐年龄求导、令其为零,就得到最优轮伐期。写成连续贴现的形式是
③ 择伐:把「不超过生长量」写成积分。异龄林每次采伐量不超过生长量,听着像原则,落地是一个积分:年允许采伐量 = ∫ G(d)·p(d) dd,G 是直径分布(Weibull 或负指数),p 是可采概率。实践中多用 BDq 法查径阶表,但审方案的人盯的其实就是这个积分的上下界与径阶权重。
还有一处常被漏掉:间伐值不值,也是求导。多抚育一次,成本现在付、收益在若干年后;折现回来比一比,就是边际分析。方案里写「第 12 年抚育间伐一次」,背后应该有一条算过的曲线,而不是一句惯例。
三、生物性资产:把「长出来的」变成「记上去的」
生物性资产是会计里最特别的一类:它会自己长,也会自己死;它的价值随时间双向变化——长材是增值,灾害、枯损、病虫害是减值。制造业的存货放一年不会变重,林子放一年会变重,也可能烧掉。
所以「生物性资产大模型」的核心不是会聊天,而是能算清这条恒等式:
左边是报表上的数,右边每一项都必须能指到数据源。
这里必须说清一件容易被含糊过去的事:口径。中国《企业会计准则第 5 号——生物资产》以历史成本为主,公允价值只有在能可靠取得时才可用;国际准则 IAS 41 则原则上用公允价值减销售费用。同一片林子,按成本法记和按公允价值记,数字可以差出一倍。所以任何「AI 测算的林地资产值」,不标注口径就是数字游戏。
还有一条边界,FCIM 白皮书处理得很干净:它明确排除碳汇、碳交易、碳信用与额外性收益,只保留「权属与绩效可核验」的生态服务付费作为第四层收入。这是刻意的克制——把碳塞进收入模型,很容易把「可能的政策红利」写成「确定性的现金流」。真想加,也得单独一层、单独折现、单独披露,不能混进木材那本账。
四、滚动:FCIM 真正需要的数学,不是一条公式
上面那三处微积分,是「一份方案」的数学。但 FCIM 管的是四十年、几十块林地、不断再投资的组合——那就不再是一个 Faustmann 能解决的事。
它需要的是滚动优化,写法大致是:
s.t. 资本约束 · 采伐限额 · 面积与龄级平衡 · 认证红线
为什么必须滚动?因为价格会变、限额会调、灾害会发生、加工收率会波动。一次性算完四十年的最优路径,第二年就作废了。FCIM 把「再收储」放在循环的最后一环,本质上是给这个滚动优化留了一个每期都可以重新决策的口子。
而「质量闸门」那句纪律,正好是这里的约束条件:扩张不是把面积加到最大,而是在组合质量、供应链稳定性、加工经济性三条约束下的内点解。
五、把两者嵌进 AI:五层架构,三条输出,四条纪律
到这里可以回答那个问题了:林业 AI 生长经营大模型,到底长什么样?我的答案是——它不是一个更会聊天的模型,而是一套分层的系统。
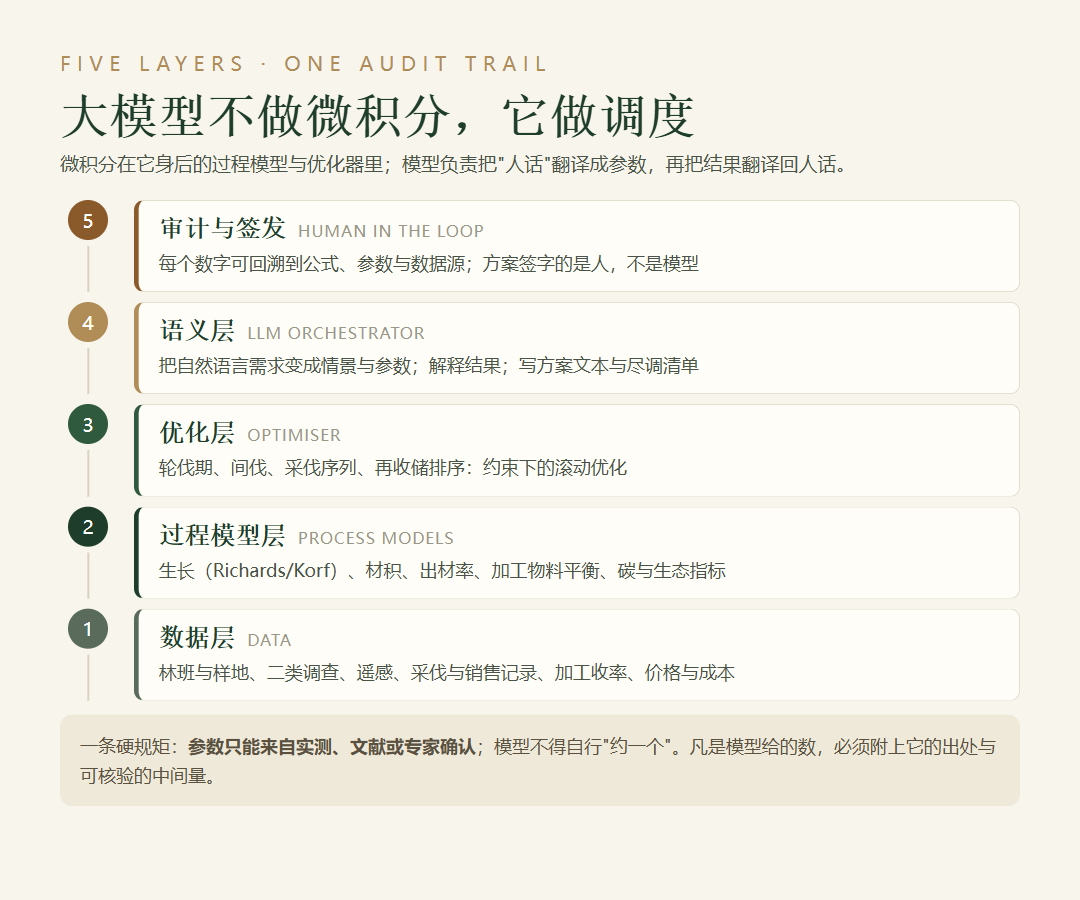
LLM 不负责积分,负责翻译与调度。它把「我想看看 25 年主伐、造林成本按每亩 8000 元」翻译成一份参数文件,交给后端的过程模型与优化器;再把跑出来的曲线、表格、敏感性分析翻译成人能读的方案段落。纯语言模型自己去「积一个直径分布」,目前还会编系数——这不是能力问题,是它没有实测数据、也没有数值积分器。
三类输出,缺一不可。① 可签的方案文本(章节齐全、符合编制规程);② 可跑的参数文件(树种、立地、密度、成本、价格、利率全部显式);③ 可核的中间量(逐年胸径/树高/蓄积、出材率、现金流、资产变动)。第三类最容易被省略,但它恰恰是审计与复核的抓手。
四条纪律,写在系统里而不是写在纸上:
落地路径也不必一步到位。最小可用的第一步,是把「生长表 + 价格 + 成本」做成一个可调参数的情景引擎:用户改一个假设,曲线与资产值立刻重算,LLM 只负责把自然语言变成那几行参数、把结果解释成人话。这一步没有任何「模型幻觉」的空间,却已经能替方案编制省掉大量重复计算。
六、结语:骨架、循环、调度器
把三件事放在一起,会发现它们的分工其实很清晰:
所谓「林业 AI 生长经营大模型」,如果它成立,大概就是这三者的乘积:算得准(微积分)、滚得动(FCIM)、说得清(大模型)。少任何一项,它都只是个会写方案的聊天框。