基于当代数学理论构建林业的 AI 生长大模型
数学子集 · 五层架构 · DeepSeek 基座与 Skill 插件:一份能落地的分工方案
先说一句可能让人不舒服的话:今天你让任何一个大模型「直接算」一片林子 30 年后的蓄积,它给你的数都是编的——不是能力不够,是它没有样地数据、没有数值积分器、也没有约束。
但这不是坏消息。真正能落地的架构,恰好是让模型别去算:数学留在它身后的过程引擎里,模型只负责「听懂需求 → 选对方程 → 调对参数 → 把结果翻成人话」。
一、先把分工定死:LLM 该做什么,不该做什么
这一节不是修辞,是架构约束。定不下来,后面每一层都会长歪。
| 它擅长(也是唯一该做的) 听懂「杉木 12 年投到 30 年,给间伐建议」 选择调用序列:先校准、再推演、后优化 把自然语言补成参数 JSON(缺项追问) 把后端返回的表格翻成方案正文 标注不确定性、来源与未验证项 | 它不该做(做了必错) 解微分方程、积分、矩阵求逆 自己编立地指数、枯损率、价格 把「约 21.3 m³/亩」这类数字拍出来 推算采伐限额、合规结论 为省事跳过校准直接给结果 |
一句话:凡是「有唯一正确答案、且需要数值方法」的事,都不该交给语言模型。它负责的是「把模糊的人话变成明确的调用」,以及「把明确的结果变成人能读的句子」。
二、数学子集:五个结构,够用十年
不是所有高等数学都值得塞进林业模型。选型标准只有一条:它能不能对上林业数据的真实状态——五年一次复位、样地稀疏、气候年际波动、多指标相关。
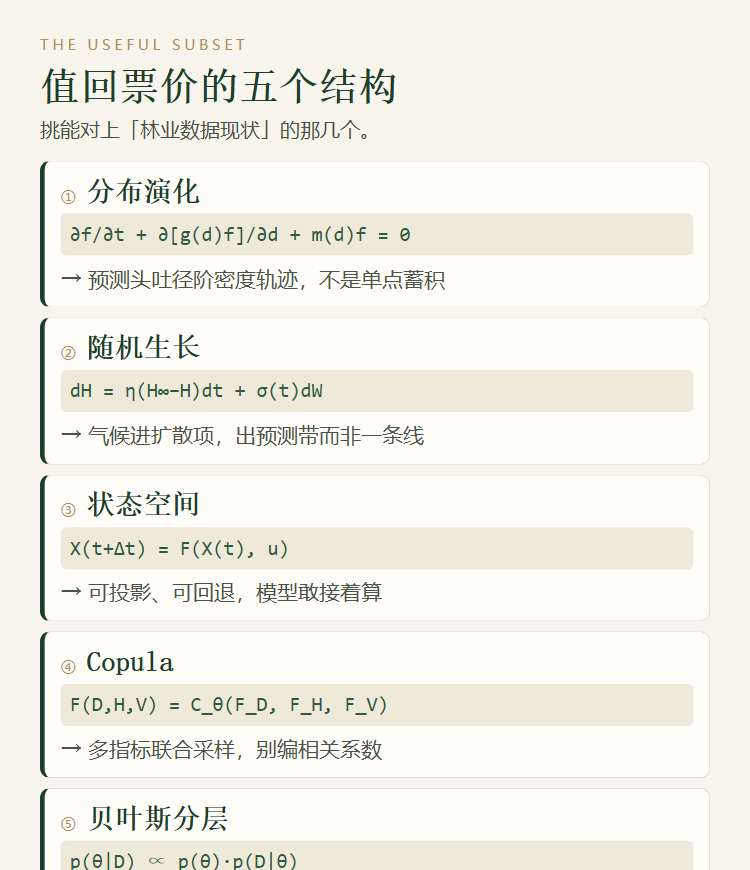
① 分布演化:径阶不是一组数,是一条密度
当林分状态用径阶密度 f(d,t) 描述时,它的演化有严格的写法(von Foerster–McKendrick 方程):
加入环境随机项后,它变成 Fokker–Planck 型方程(扩散近似):
落到 AI 里,这一条改变的是输出形态:预测头不该吐一个「蓄积 = 312」,而该吐一条径阶密度轨迹,再由它积分出蓄积、出材率、碳量。下游所有指标才自洽。
② 随机生长:单木是 SDE,不是一条平滑曲线
以树高为例,最稳的写法是把 Bertalanffy 型平均生长写成随机微分方程:
两个容易写错的地方,值得单独说:
这一条落到 AI 里,改变的是输出的确定性:预测从「一条线」变成「一条带」。页面上那个「±」不是装饰,它决定了经营决策敢不敢下。
③ 状态空间:可投影、可回退,模型才敢接着算
把林分压成一个状态向量(例如高度 H、密度 N、断面积 G、蓄积 V),再定义转移函数:
转移函数必须满足两条硬性质,否则系统会「漂移」:一致性(Δt = 0 不改变状态)与路径无关(分两段投和多段投结果一致)。 有了这两条,模型才能从「第 7 年」接着投到 31 年、也能回退重投——这正是对话式系统必须的。
这里我要补一个元宝那份没提、但在真实运营里更常用的东西:数据同化。样地五年才复测一次,中间这些年状态怎么办?用卡尔曼滤波或粒子滤波把每一次观测(包括遥感、巡护、临时样地)吃进去,持续修正 X 与参数。纯 MCMC 做的是「一次性校准」,滤波做的是「持续跟踪」——后者才是运营的日常。
④ Copula:多指标的相关结构,别让模型自己编
胸径 D、树高 H、蓄积 V 之间高度相关。假设多元正态是最省事、也最容易失真的做法。Sklar 定理给了更一般的答案:
用处很具体:碳汇计量里「大径木干形变异小」这类尾部相关;样地缺失时的条件采样;以及——最容易出事的地方——让模型生成多指标预测时给一个真实的相关结构,而不是拍一个相关系数。
⑤ 贝叶斯分层:参数是分布,小班之间要「部分借力」
这是我认为整篇文章里最该强调的一条,也是很多「林业 AI」方案最容易跳过的一条:
为什么必须这样?因为小样本下参数根本不可辨识:一个林分十来次观测,却要估四五个参数,解不唯一。解法不是换更好的算法,而是加先验、加分层、加约束——这也是「生长表」在历史上真正的价值:它是一个强先验。
对 AI 系统的要求是:Skill 返回的永远是「0.73 ± 0.05」而不是「0.73」,并且带上收敛诊断。下游所有预测都要能把这个不确定性传下去——传到轮伐期、传到现金流、传到「这块地该不该收」。
⑥ 再往上一层:可微物理,但先别急
把生长方程写进损失函数(PINN/UDE),让神经网络只学「机理方程补不上的残差」——气候适应、病虫害、立地异质。这在学术上很热,在县级林业局还不到能用的时候。但架构上要留接口:把过程模型包成可微层,是为了将来能用样地数据反传调参数,不是为了让今天的报告更好看。
三、五层架构:数学在下面,语言在上面
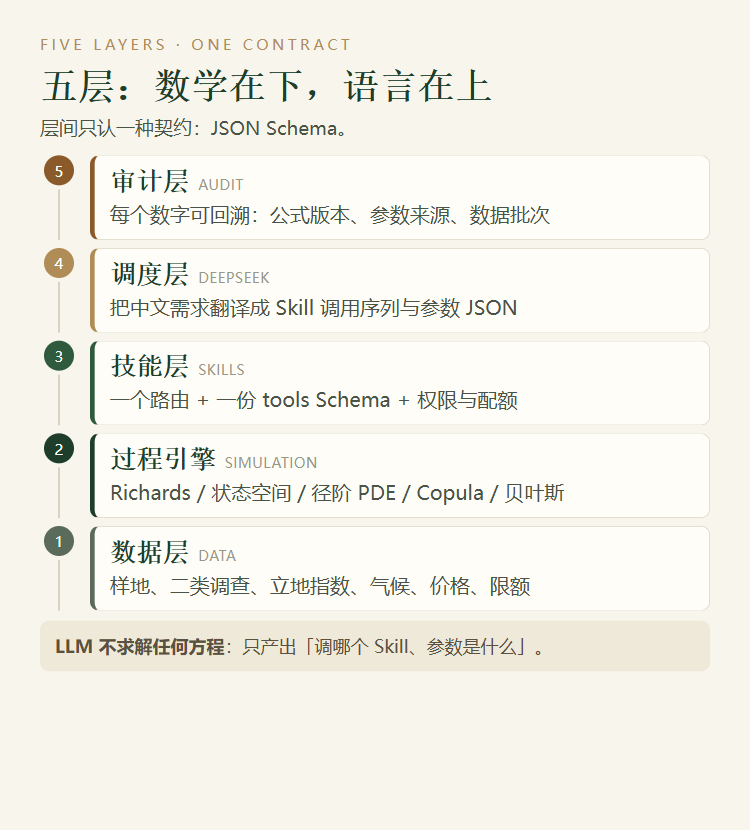
这套分层不新鲜,但每一层的边界必须写死:
四、为什么用 DeepSeek 做基座,以及怎么接
选它做调度层,理由很实际,不是站队:
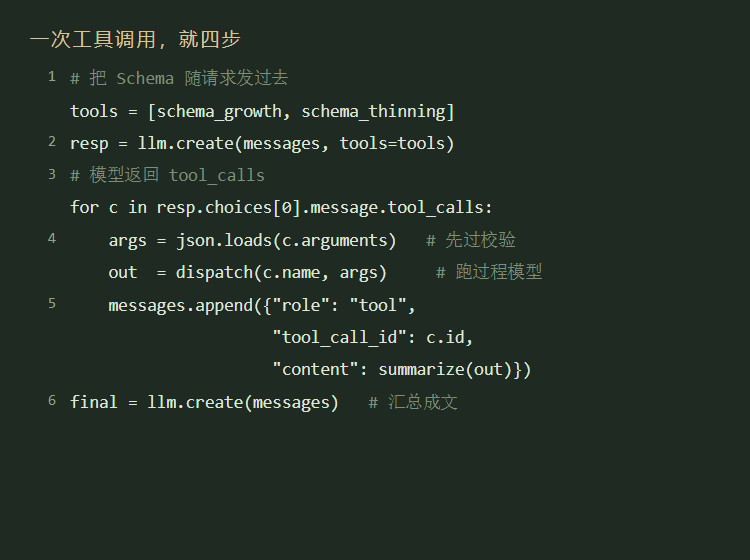
一次工具调用就四步,没有任何魔法:
我建议再往前一步:把 Skill 定义成与模型无关的标准描述(OpenAI tools Schema,或 MCP 那套工具描述)。这样将来换基座、或者让别的系统来调你的林业引擎,都不必重写一遍。
五、七个 Skill:七个「不许模型自己算」
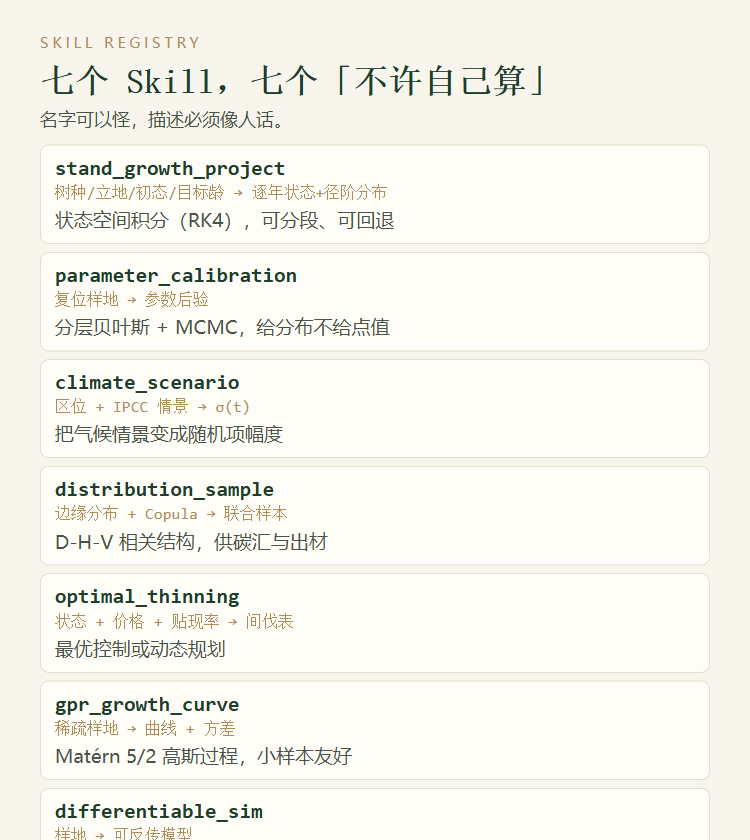
这七个的划分不是我拍脑袋:它们正好覆盖「校准 → 情景 → 推演 → 抽样 → 优化 → 兜底 → 进阶」这条链。少一个,链路就断在某处。
其中 optimal_thinning 用最优控制(Pontryagin 或简化的 HJB)是理论上的正解;但工程上,离散间伐方案用动态规划更稳——状态少、边界清楚、好解释。这一点比用哪个数学工具更重要。
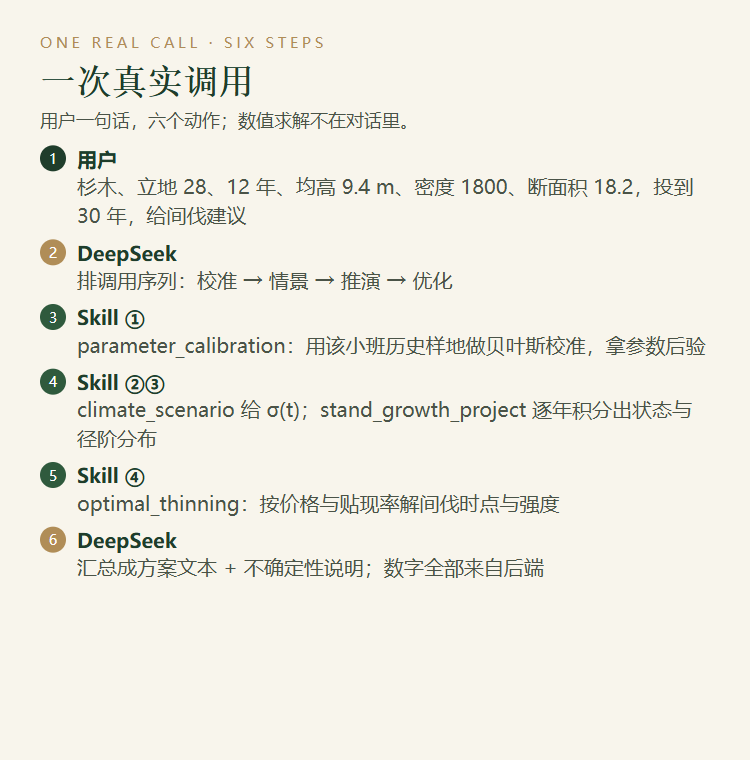
六、一次真实调用长什么样
这张图里最容易被忽略的是第 6 步之后的那个「回写」:后端返回的不只是结论数字,还有中间量——逐年状态、径阶分布、参数后验、收敛诊断。少了中间量,审核的人无法复核,这套系统就永远只能当玩具。
七、它长什么样:三个岗位,三段对话
上面讲的全是架构。但大多数林业的同行想问的其实是一句更朴素的话:这东西打开长什么样,能帮我干什么活?
我把它画出来(界面示意,不是已上线产品)。它不像聊天机器人给你一段话,更像一个会算的同事:你说一句话,它回一张带数字、带区间、带出处的卡片,底下永远有「看依据」「看中间量」。
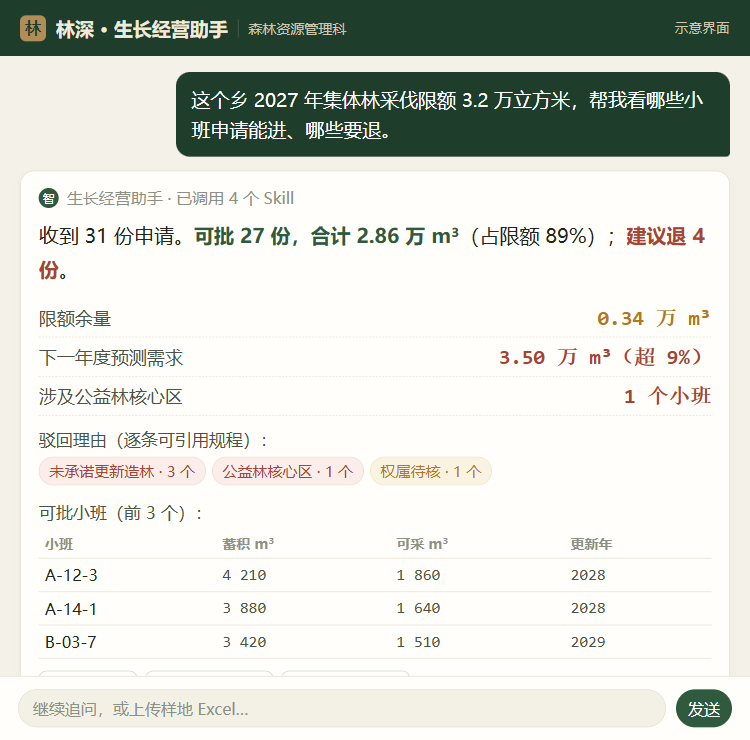
① 森林资源管理科:31 份采伐申请,先替你看一遍
每年的限额分配是最磨人的活:31 份申请、限额 3.2 万立方米,要逐条对公益林、对更新造林承诺、对权属。人工看一遍,两天。
它做的不是"批准",而是把该看的都摆到你眼前:哪些能进、哪些要退、退的理由是什么、限额还剩多少、明年预测会不会超。最后那张预审表还要你盖章——它只是让你不用再翻两天 Excel。
② 林业开发机构:6800 万收不收,先算清楚
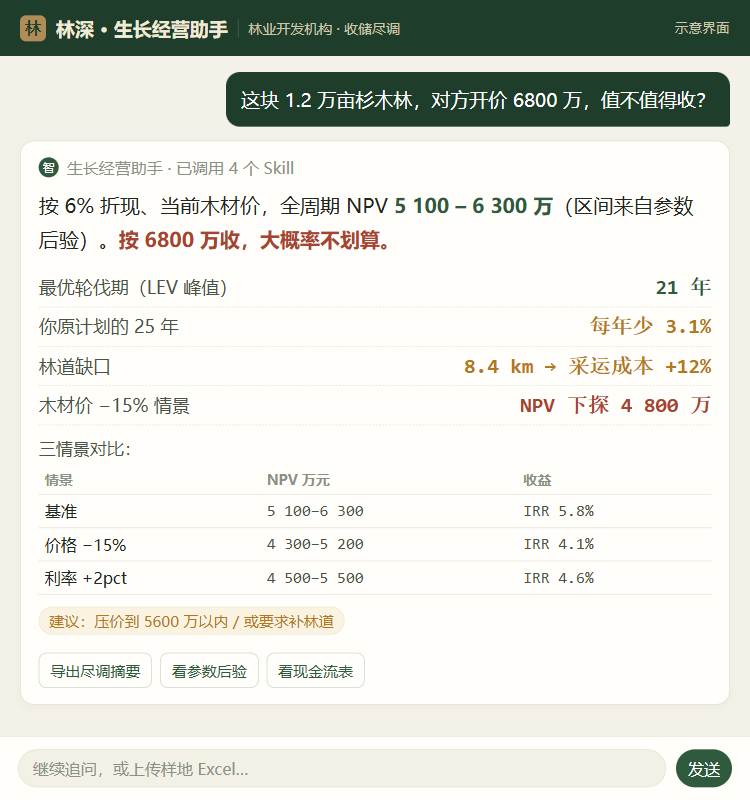
收储尽调最怕"凭经验拍价"。卖方开 6800 万,你心里得有个数:按这个价,全周期 NPV 是多少、最优轮伐期是第几年、林道缺口要不要补。
注意几个细节:NPV 给的是区间(来自参数后验,不是拍一个数);最优轮伐期 21 年,直接点出"你原计划 25 年,每年少 3.1%";林道缺口 8.4 km 换算成采运成本 +12%—— 把"值不值"拆成几个能被追问的量。
③ 林业规划设计院:6 章 24 节的初稿,一下午变两小时
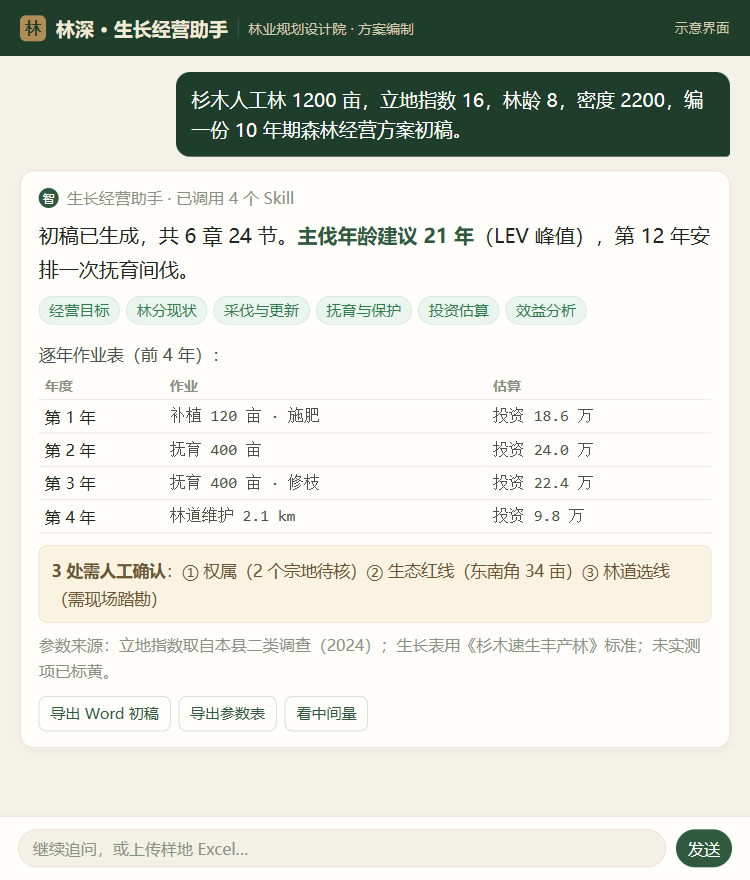
编方案最耗时的不是写,是找数:立地指数在哪张表、生长表用哪版、主伐年龄怎么定、逐年作业怎么排。
这张卡片里最关键的不是"生成了 6 章",而是最后那三行:3 处需人工确认(权属、生态红线、林道选线),以及参数来源一行(立地指数取自哪年的二类调查、生长表用哪版标准、未实测项标黄)。这一行决定了这份初稿能不能拿去评审——评审最先问的就是"你这个数哪来的"。
所以它不是一个"聊天窗口",而是四样东西的合体:对话入口 + 结果卡片 + 可导出的交付物 + 一条能查的审计链。前两样让人愿意用,后两样让人敢用。
八、工程红线:六条,踩一条就白做
九、训练与微调:底座不用训,该做的是这三件
第一,别去预训练林业语料。通用能力已经够用,钱应该花在数据与参数上,不是花在底座上。
第二,造路由样本。几百条「用户问法 → 正确工具序列」放进系统提示,或做一次 LoRA。比如「投到 30 年出材」→ 生长推演;「间伐几次划算」→ 生长推演 + 最优间伐;「这棵树是什么」→ 不调工具。
第三,把生长表做成 RAG。《杉木生长表》《立地指数表》《造林技术规程》进向量库,让模型先检索、再填参数——这一步能显著降低「参数幻觉」,因为参数有出处了。
至于「把过程模型包成可微层、端到端反传」,这是「加了聊天的生长模型」和「真正的林业 AI」的分水岭。但现在不急着跨——先把前两件事做扎实,收益更大。
十、边界:三句实话
十一、最小骨架:一两百行能跑起来
别一上来就画大架构。先把「一句话 → 一个 Skill → 一段结果 → 一段文本」跑通:
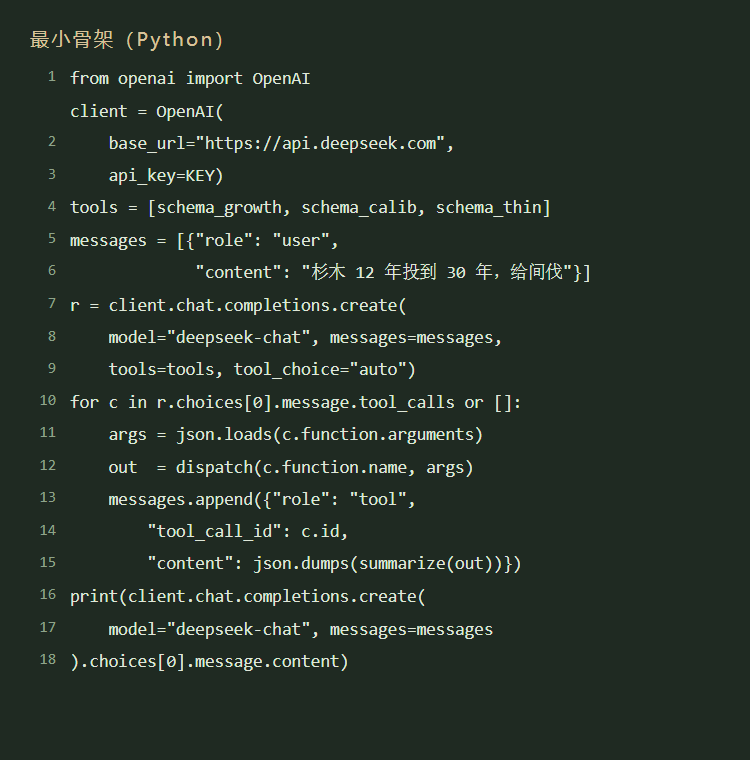
这里每一行都可以替换:base_url 换成别的模型、dispatch 换成 FastAPI 或消息队列、summarize 换成你的截断策略。骨架不变,因为它守住了那条底线:数值不在对话里算。
结语:三层,一句话
三者拼起来,才叫林业 AI 生长大模型。缺了第一层,它是个会背生长表的聊天机器人;缺了第三层,它是个没人敢用的黑箱。
而它最终要服务的,是那几个具体的问题:这片林子第几年主伐、这块地该不该收、这笔钱该不该再投进去。模型不必知道答案,只要能把问题正确地送到会算的地方。